Nvidia je dominantním hráčem v AI byznysu, přinejmenším pokud jde o hardware, na kterém různé aplikace umělé inteligence běží, a obvykle se její vedení považuje za téměř neotřesitelné. Je tak překvapivé, že se jí teď zdá se přihodilo ne úplně malé zaškobrtnutí. Firma teď dodatečně výrazně zhoršila parametry svého nejnovějšího AI GPU – 3nm akcelerátoru Rubin. A to přesto, že dle vlastních slov ho firma vyrábí od května a už i dodává klientům.
Nvidia zpětně zpomaluje Rubin
O detailech AI akcelerátoru Rubin od Nvidie jsme psali v červenci, kdy firma GPU prezentovala na konferenci SIGGRAPH 2026. Ještě tehdy firma uváděla, že akcelerátor složený ze dvou výpočetních čipletů (a přídavných IO čipletů) dosahuje propustnosti pamětí 22 TB/s, přičemž jde o paměti HBM4 s celkem 8192bitovou sběrnicí. To by mělo znamenat efektivní přenosovou rychlost na jeden bit sběrnice 22 Gb/s.
Tato plánovaná rychlost pamětí HBM4 byla výrazně vyšší, než jakou AMD používá u svého vlastního AI akcelerátoru Instinct MI455X, který sice dosahuje o něco vyšší propustnosti 23,3 TB/s, ale je to na o 50 % širší paměťové sběrnici (12 288 bitů, 12 pouzder HBM4), efektivní rychlost na jeden bit sběrnice by měla být jen cca 15,53 Gb/s.
Nvidia ale potichu provedla změnu specifikací. Nyní už na svém webu uvádí horší specifikace, které snížily propustnost pamětí HBM4 na 19,2 TB/s. Je tedy o 12,7 % horší, než co Nvidia prezentovala ještě před pár měsíci, byť frekvence bude pořád vyšší, než efektivní frekvence používaná u GPU od AMD. Náskok Instinctu MI455X v celkové propustnosti pamětí se tímto zvýší na 21 %.
Zajímavé na tom je, že tato změna přichází velmi pozdě. Podle Nvidie bylo GPU Rubin v sériové výrobě už 31. května letošního roku a tento podzim už ho dostávají klienti. Velcí zákazníci typu cloudových hyperscalerů ale dostávali dodávky ještě předtím. První vzorky dokonce měli klienti již v únoru. Na testování tedy bylo dost času, takže je zvláštní, že Nvidia parametry reviduje až teď – a tři měsíce po veřejném představení parametrů.
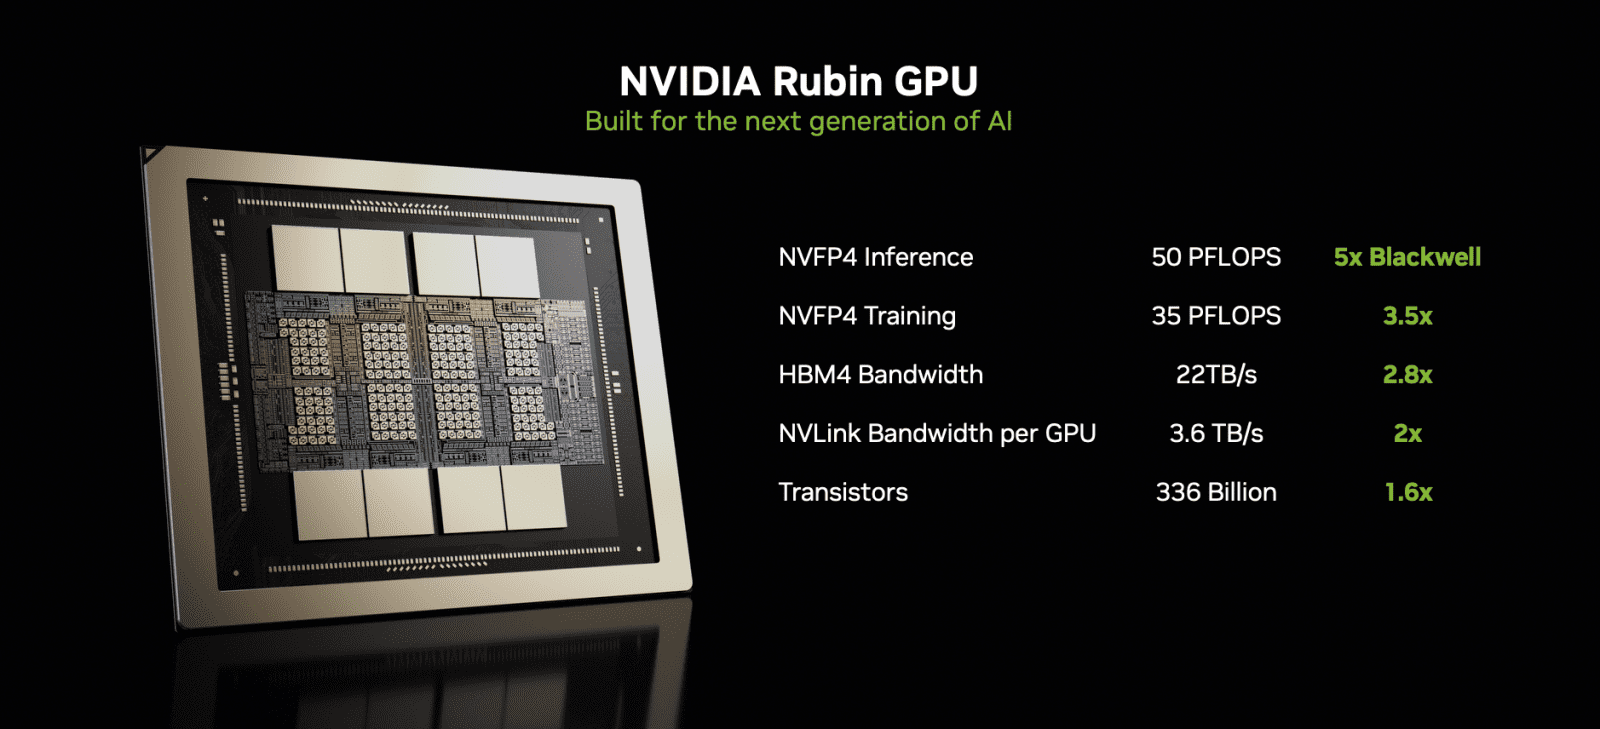
Nvidia Rubin: Původní specifikace, které Nvidia zpětně zrušila
Tyto změny se týkají jak samostatného GPU Rubin, tak i kombinace procesoru Vera a GPU Rubin (čemuž Nvidia říká „Vera Rubin Superchip“). A specifikace budou takto zhoršené i ve velkých AI kabinetech Nvidia Vera Rubin NVL72. Nejde tedy o to, že by byly oslabené parametry levnějších méně důležitých verzí, ale u vlajkových modelů by zůstaly zachované původní rychlejší specifikace.
Nejen paměti, ale i NLink
Jedno možné vysvětlení je, že Nvidia přecenila možnosti křemíku, který navrhla, a frekvence pamětí musely být zpomalené, protože s původně plánovanými takty nebyl akcelerátor stabilní nebo výtěžnost výroby není dostatečná, aby se s touto specifikací produkt dal prodávat. Ale to, že nakonec Rubin bude vyráběn a dodáván s pomalejší frekvencí pamětí HBM4, by se teoreticky dalo připsat i faktorům, za které Nvidia nemůže. Mohlo by to totiž být tak, že původně plánované hodnoty se nedaří dosáhnout na straně pamětí, které Nvidii dodávají Hynix, Micron nebo Samsung, takže se rychlost musí snížit, ale nebyla by to vina Nvidie.
Nicméně ve specifikacích, které má Nvidia teď na svém webu, firma současně snížila i rychlost rozhraní NVLink pro komunikaci mezi GPU v systému. Celková propustnost rozhraní GPU Rubin měla být 3,6 TB/s, respektive 7,2 TB/s u komplexu Vera Rubin Superchip. Celý rack NVL72 měl mít souhrnnou propustnost 260 TB/s. Nově revidované specifikace toto redukují jen na 3 TB/s, 6 TB/s a 216 TB/s pro rack NVL72. Jde o redukci propustnosti o 16,7 %. Opět by to mělo být proto, že musela být snížena pracovní frekvence.
Řadiče a PHY, na kterých frekvence dosažená rozhraním NVLink závisí, jsou už jen v režii Nvidie. Frekvence komunikace je omezená i kvalitou použité kabeláže nebo PCB sloužících pro propojení, ale to by asi nebyl důvod zhoršit specifikace čipu samotného. A mělo by to být řešitelné zkrácením vzdáleností či použitím kvalitnějších komponent. Tudíž by pomalejší NVLink asi měl spíše svědčit o tom, že návrh čipu Rubin nevyšel zcela podle původních ambicí Nvidie, případně že nastavila specifikace příliš ambiciózně na to, co dokáže 3nm výrobní proces TSMC opravdu vyrábět.
Nvidia mimochodem také zhoršila specifikace jednoho ze svých serverů, systému HGX Rubin NVL8. U toho se také snížila kapacita paměti z 2,3 na 2,0 TB a propustnost klesla ze 176 TB/s na 130 TB/s. Vedle horších frekvencí tedy Nvidia i použité akcelerátory osekala. Firma zhoršila i slibované parametry výpočetního výkonu. Trénování s datovým typem NVFP4 má dosahovat 270 PFLOPS místo 280 PFLOPS slibovaných původně a výkon při použití FP6 či FP8 klesl z původně specifikovaných 140 na 130 PFLOPS.
Zdroje: VideoCardz


 ČLÁNKY DO MAILU