
Nedávno jsme psali o učiteli, který studentům předhodil past v podobě neviditelného textu v zadání písemky. Ti jej zkopírovali do AI chatbotů a nechali vygenerovat odpovědi. Většině z nich nebylo divné, že v nich jsou zmínky o Madagaskaru. Nejspíš proto, že je vůbec nečetli. Zanedlouho ale budou mít nejen učitelé snadnější práci – do chatbotů postupně zamíří techniky, které budou AI obsah označovat.
Neviditelný otisk
Jako první zveřejnil tento záměr Anthropic pro svoje nástroje Claude, který tím reaguje na AI akt platný v Evropské unii. Jakýkoliv text, který bude vygenerovaný v některém z nových modelů, bude obsahovat otisk, který bude výrazně zjednodušovat detekci AI obsahu. Anthropic prozatím nástroj pro detekci neuvedl, postupně jej ale dostanou uživatelé i vývojáři.
Firma neuvedla bližší informace o tom, jakou konkrétní techniku bude využívat, nejvíc se ale spekuluje o tzv. green list tokenech, či token biasingu. Princip je poměrně jednoduchý: při generování textu má AI v každém kroku na výběr několik slov či částí slov (tokenů) a některá z nich může systém nenápadně zvýhodňovat. Které tokeny dostanou přednost, se průběžně mění podle předchozího textu a tajného klíče, takže výsledný text na první pohled nevypadá nijak neobvykle. Pokud se ale stejný princip opakuje ve stovkách voleb za sebou, vznikne v textu statistický vzor připomínající neviditelný otisk.
V této technice se tak nepoužívají žádné skryté znaky nebo metadata, která by šla velmi snadno odstranit. Detektor zveřejněný vývojářem modelu následně bude hledat v textu (použitých tokenech) statistický vzorec odpovídající předem použitému klíči. Ten se může mírně změnit při parafrázování textu, případně při jeho překladu. Stále ale zůstane v textu z velké části zachovaný. Výsledkem detekce potom bude pravděpodobnost toho, že se jedná o obsah generovaný pomocí AI:
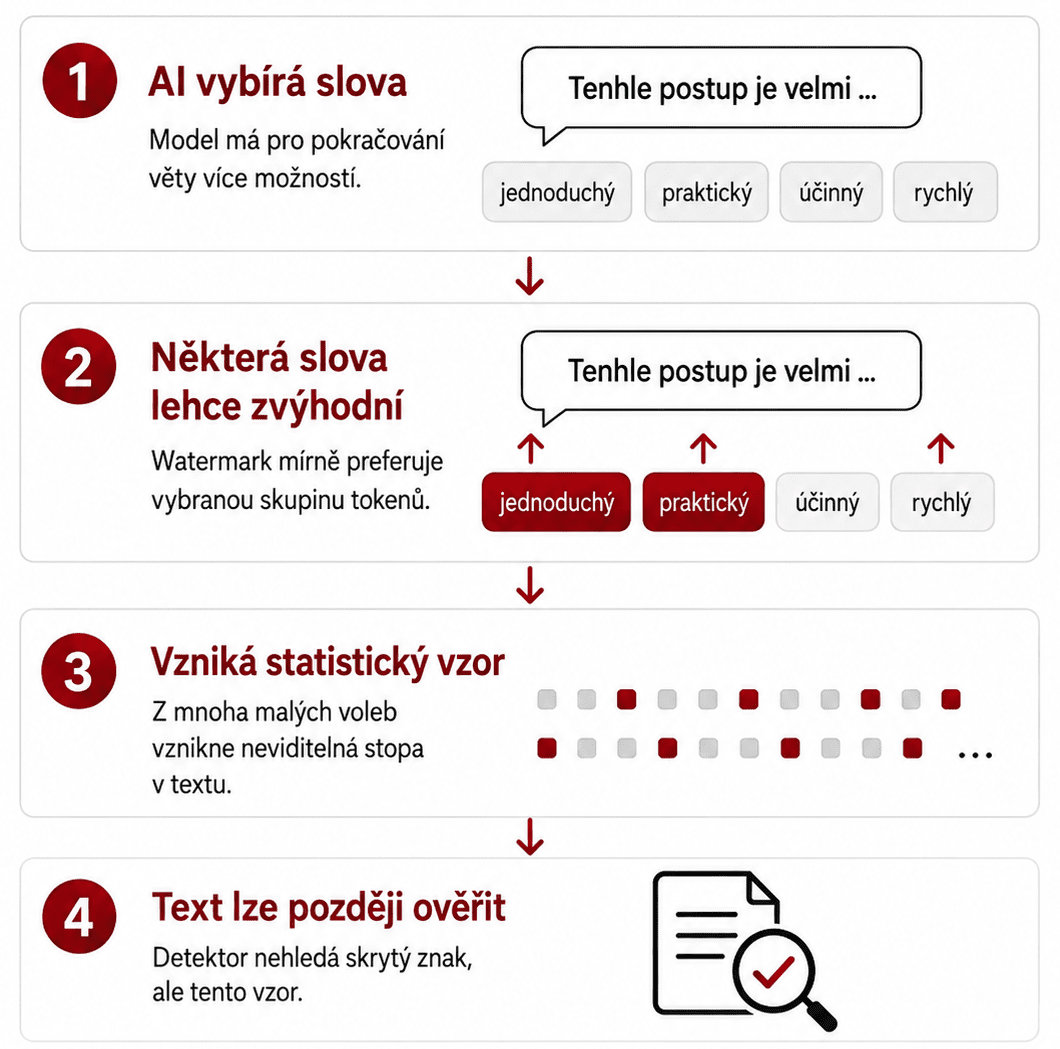
Princip, na kterém bude pravděpodobně fungovat otisk v textu z Clauda.
Kvůli AI aktu budou muset do generovaného textu (i jiného obsahu) postupně začít vkládat i další AI společnosti. Například OpenAI již před dvěma lety potvrdila, že na otiscích v textu pracuje, rovněž ale použitou techniku nezveřejnila. Nejspíš ale rovněž půjde o token biasing.
V současné době na internetu existuje nespočet služeb, které detekci AI textu slibují. Jen velmi malá hrstka z nich ale funguje, navíc primárně v angličtině. Pro ostatní jazyky nemají vývojáři těchto nástrojů dostatečné množství dat, na kterých by spolehlivý detektor vytrénovali.
V okamžiku, kdy Anthropic a další firmy vydají svoje detektory, začnou samozřejmě vznikat nástroje, které budou tyto otisky odstraňovat. Byť totiž nebude veřejně známá sada klíčů, podle kterých LLM zvýhodňuje tokeny pro tvorbu otisku, postupně půjde alespoň pravděpodobný vzorec odhalit a text parafrázovat na místech, kde se mají vyskytovat tokeny využité k detekci. AI firmy si tak budou moci odškrtnout splnění regulační podmínky Evropské unie a žáci budou odpovědi do písemek kopírovat přes jeden nástroj navíc.
Zdroj: Claude


 ČLÁNKY DO MAILU