
Zřejmě je to tím, jak se Intel i AMD dostávají pod větší tlak konkurence procesorů Arm od různých výrobců, ale před dvěma lety obě firmy překvapivě uzavřely spojenectví v konsorciu x86 Ecosystem Advisory Group. Zatímco dřív se Intel snažil z nových rozšíření instrukční sady dělat nástroj proti konkurenci (AMD), do budoucna firmy chtějí novinky vyvíjet společně. Teď oznámily nové budoucí instrukce spolu a právě v tomto konsorciu.
Na webu x86 Ecosystem Advisory Group se koncem října objevil dokument se specifikacemi příští generace rozšíření procesorů x86, pod nímž je jako autor podepsáno už jen konsorcium, nikoliv jeho jednotliví členové. Tento dokument specifikuje nová rozšíření ACE v2 a AVX10.3. Obě by tedy měla být inkrementálními přídavky.
ACE v2
První rozšíří instrukce ACE, které byly odhalené nedávno a zatím je ještě žádné CPU neumí (u AMD je má podporovat architektura Zen 7). ACE jsou instrukce pracující s maticemi, které budou primárně užitečné pro různé výpočty umělé inteligence. Jde tedy o obdobu dřívějších instrukcí AMX v procesorech Intel a jednotek SME v procesorech Arm.
ACE v2 by zdá se mělo rozšiřovat schopnosti práce s 8bitovými datovými typy a zřejmě i se 4bitovými formáty MX FP4 a MX INT4, což by mělo mít užitečnost skutečně jen pro AI. Nicméně přidané jsou i operace pracující s běžnou jednoduchou přesností FP32 a také s dvojitou přesností FP64. Takže ACE v2 by mohlo být použitelné i pro obecnější numerické a vědecké výpočty v HPC aplikacích, pokud umí využít operace outer product, které rozšíření ACE s maticovými registry provádí.
Rozšíření také přidává některé nové instrukce pro správu maticových registrů a BSR (block scale registru).
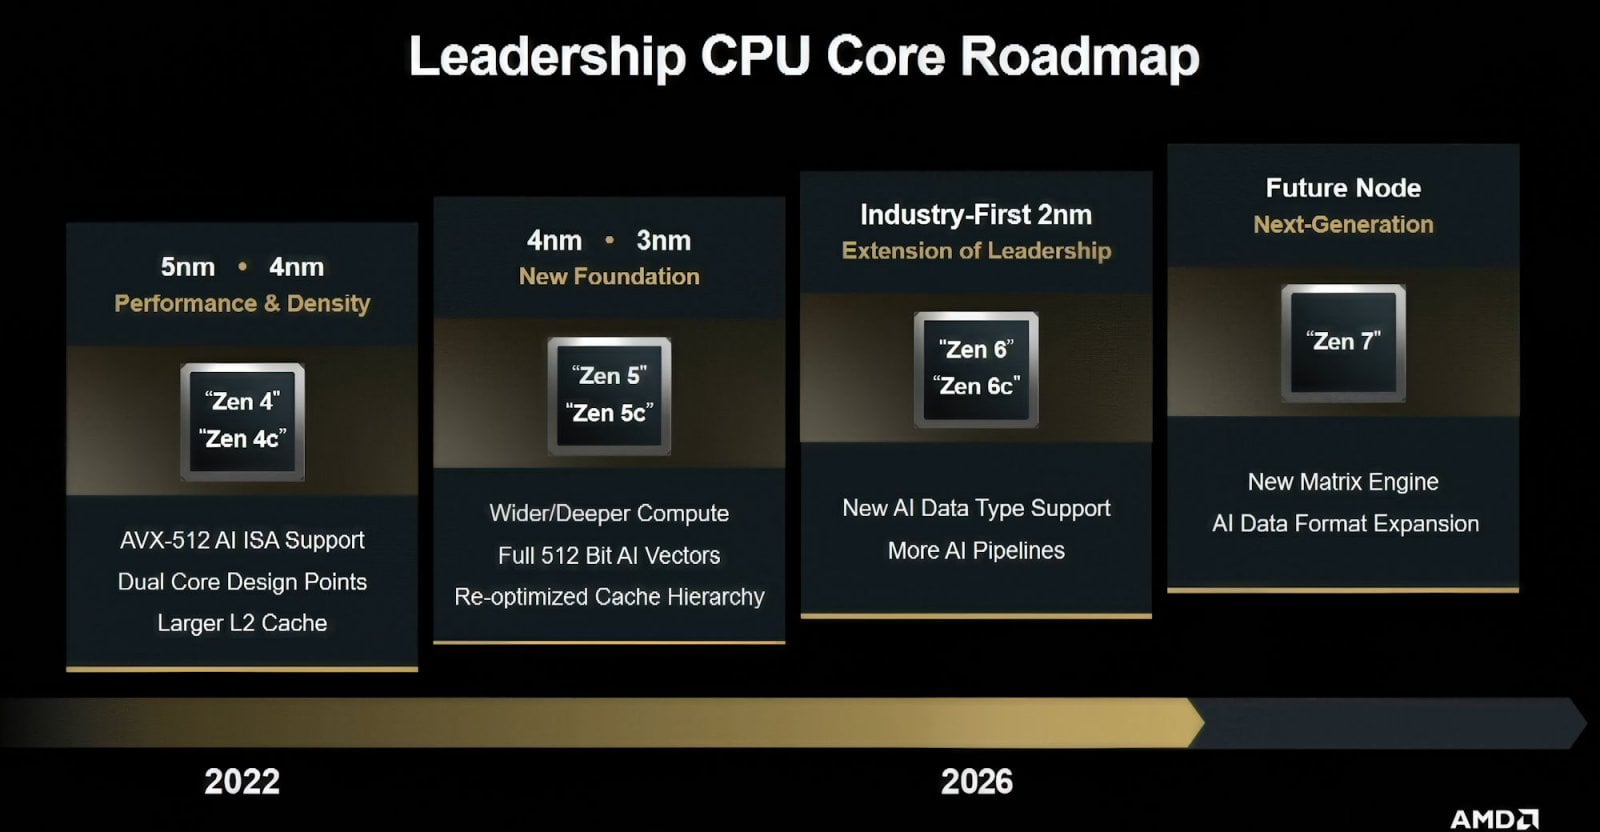
První generace instrukcí ACE bude podporována v jádrech Zen 7 od AMD (Roadmapa CPU architektur AMD z Financial Analyst Day 2025)
AVX10.3
Druhé rozšíření pak bude přídavkem k AVX-512, AVX10.1 a AVX10.2. Nové přídavky zahrnují instrukce pro konverze číselných hodnot do 8bitových a také do 4bitových formátů se sníženou přesností, které (jak už bylo zmíněno) používají operace umělé inteligence. Toto rozšíření je přidáno celkem logicky proto, aby procesory měly instrukce, kterými si připraví např. FP8 a FP4 data, jež pak budou používat k výpočtům s instrukcemi ACE v2.
Rozšíření ACE bylo od začátku navrženo tak, aby se doplňovalo s využitím instrukcí AVX10, které lze používat pro přípravu a zpracování vstupních dat, takže s rozšířením schopností ACE teď Intel a AMD logicky také přidávají odpovídající funkcionalitu do instrukcí AVX10. Konverze na hodnoty FP4, INT4 nebo FP8 a INT8 fungují s různými formáty 16bitových jako vstupem, například FP16 či BFloat16.
Pochopitelně se přitom používají 512bitové SIMD registry pro vysokou propustnost těchto výpočtů, ale použít lze i menší registry. Operace mohou použít jen jeden vstupní registr, nebo dva, jelikož například při konverzi FP16 na FP8 se celkově 512bitový vstup (32 hodnot FP16) zmenší na 256 bitů (32 hodnot FP8).

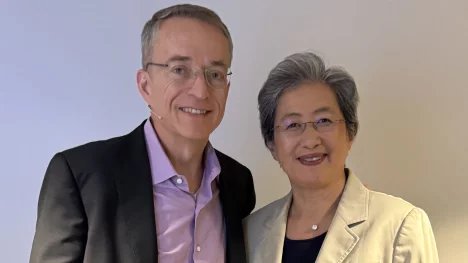
CEO AMD Lisa Su a tehdejší ředitel Intelu Patrick Gelsinger při založení x86 Ecosystem Advisory Group
BMM
Součástí rozšíření AVX10.3 jsou také instrukce Bit Matrix Multiply BMM či přesněji AVX10_BMM. Jde ovšem o součást volitelnou. Přítomnost BMM není přímo implikována podporou AVX10.3 a software si podporu musí zjistit zvlášť.
Tyto instrukce provádí maticové násobení (respektive operaci multiply-accumulate, která funguje jako XOR redukce nebo OR redukce) nad maticemi o 16 × 16 hodnotách, kde jednotlivé hodnoty jsou 1bitové (0 nebo 1). Mělo by jít o rozšíření instrukcí GFNI, které pracovaly s 8×8bitovými maticemi. Při použití 512bitových registrů (ZMM) instrukce BMM provedou dvě tyto nezávislé operace najednou, jelikož do těchto registrů se vejdou dvě sady vstupů.
Součástí rozšíření BMM je také instrukce VBITREV. Ta podporuje práci se 128bitovými, 256bitovými i 512bitovými registry a dělá to, že v každém bajtu vstupu otočí pořadí bitů. Lze použít maskový registr pro ovládání toho, které bajty zpracovat.
Bude využití mimo servery a AI?
Zmiňovali jsme, že většina těchto instrukcí je evidentně míněna zejména pro použití v různých AI aplikacích, které nyní jak se říká hýbou světem – s možnou výhradou rozšíření ACE o 32bitové a 64bitové výpočty. Instrukce pro bitovou manipulaci by mohly mít různé obecnější využití, ale dost možná také hlavně vr specializovaných operacích a při ruční optimalizaci a vektorizaci kódu.
Nicméně je možné, že využití pro AI instrukce by mohly mít i hry. V těch se umělá inteligence využívá ve grafice, kde typicky běží na GPU, ale akcelerace na jádrech procesoru pomocí instrukcí ACE by mohla být výhodnější třeba pro ovládání nepřátel nebo dalších postav.
Zatím není známo, v kterých generacích procesorů od AMD a Intelu by se tyto novinky mohly objevit.
Harmonizace instrukčních rozšíření mezi Intelem a AMD
Už předchozí práce x86 Ecosystem Advisory Group by měla přinést sladění instrukčních rozšíření a schopností procesorů Intel a AMD. Firmy se v něm dohodly na tom, že v budoucnu se stanou standardem zmíněná SIMD rozšíření AVX10 a maticové rozšíření ACE a dále technologie FRED modernizující práci s přerušeními a rozšíření pro tagování paměti (ChkTag).
Tato harmonizace neprobíhá jen tak, že AMD dostane instrukce, které vyvinul Intel. Velká změna je v tom, že to začíná fungovat i druhým směrem. Zdá se, že maticové rozšíření ACE bylo zřejmě iniciováno AMD a je hlavně jeho dílem, místo aby bylo jako standard přijato už vydané a částečně odlišné rozšíření AMX od Intelu. Intel také opustil myšlenku, že AVX10 bude primárně 256bitové rozšíření s pouze volitelnou 512bitovou podporou; místo toho bude AVX10 povinně 512bitové, takže bude plně kompatibilní s AVX-512.
Intel také opustil technologii x86S (i když v tomto případě není jasné, zda kvůli odporu AMD). Zatím není jasné, zda bude standardizováno rozšíření APX. Některé zprávy hovořily o tom, že ano. Zatím to však není jasné, objevují se názory, že standardem se stane až nějaká jeho pozdější revize a nikoliv první verze, kterou nyní budou podporovat procesory Intel Core Ultra 5000 (Nova Lake).

Zdroj: x86 Ecosystem Advisory Group


 ČLÁNKY DO MAILU